[情報] NVIDIA 怎麼用合成資料教模型上網搜尋:5 萬筆種子只留 7,000 筆
適合想用合成資料微調模型、或想教 agent 用工具的人。這是 AI Engineer World's Fair 的 55 分鐘工作坊,有三本 notebook,這裡整理概念和數字,程式碼請回原片和 repo。〔2:13〕
一、想讓 agent 學會一個行為,先把它變成一份資料
Dhruv Nathawani 是 NVIDIA 的研究員,在 Nemotron 團隊做訓練資料。這場工作坊的問題是:你想要 agent 會某個行為,能不能替這個行為做出資料,再拿來訓練模型。他們做的工具叫 Data Designer,是開源的合成資料框架。這次的例子是搜尋,但做法可以換到別的任務。〔0:12〕 〔1:13〕
他引用 Andrej Karpathy 的話:網路上的資料不是你要拿來訓練 transformer 的資料。網路資料要清洗、篩選才能用;他們的做法是直接合成,可以從零生,也可以從一份種子資料集長出來,這樣生出來的東西有真實資料在撐。〔3:14〕 〔4:16〕
他說 Data Designer 已經產出約 6.5 兆個 token 的訓練資料。〔4:40〕
二、一直叫 LLM 生資料,十幾次後就開始重複
最直覺的做法是寫個迴圈,叫 LLM 跑一百萬次「給我一個產品、一則評論、一個客戶」。他說問題是多樣性:大概 10 到 20 次後就開始重複;欄位之間也沒有關聯、沒辦法控制方向,也沒有驗證。〔5:16〕
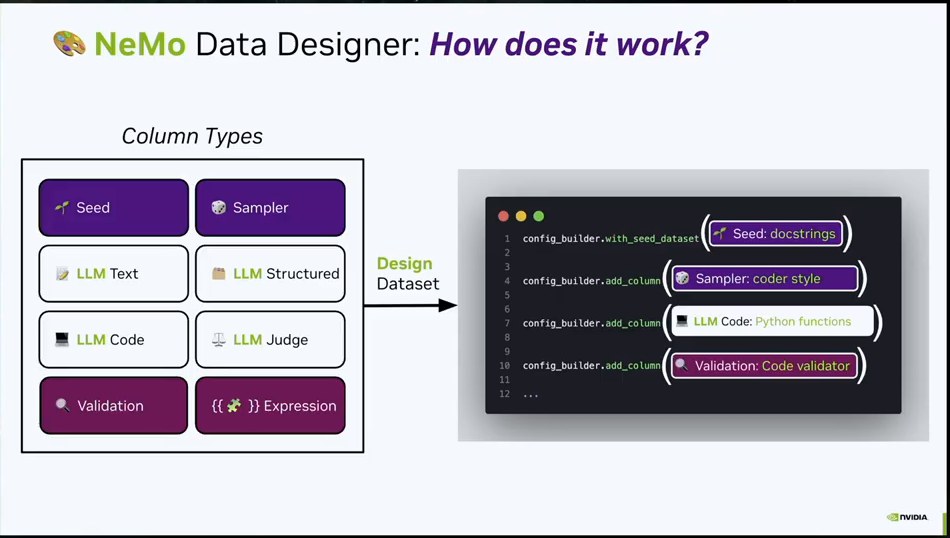
Data Designer 改成一欄一欄生。先放種子欄位,可以是任何 CSV、JSONL、Parquet,包括公司自己的資料;再加 sampler 欄位注入多樣性,例如程式題分簡單、中等、困難,每一級再對應不同題型;然後才是 LLM 生成的文字、結構化資料、程式碼和評分欄位。整個流程描述成一張圖,按一次就能產出資料集。〔6:16〕 〔7:16〕
三、先 preview 幾筆,看過再跑大批
第一本 notebook 從維基百科主題清單當種子,加難度和題型的 sampler,用 Jinja 樣板把主題塞進 prompt,讓每個 prompt 都不一樣。結構化欄位如果 LLM 沒照格式回,那筆就直接丟掉。〔10:19〕 〔11:19〕
preview 模式會先產三筆讓你看。他示範的題目是「哪個 W3C 推薦標準的縮寫,剛好是挪威某城市的機場代碼」,再用另一個模型當評審替題目打分。他強調做資料是反覆修的:看了不滿意就改流程、改 prompt,滿意了才送去批次跑。〔12:20〕 〔17:22〕
- 先產幾筆自己看過,再決定要不要跑大批。
四、題目要難到模型背不出來,才逼得它去搜尋
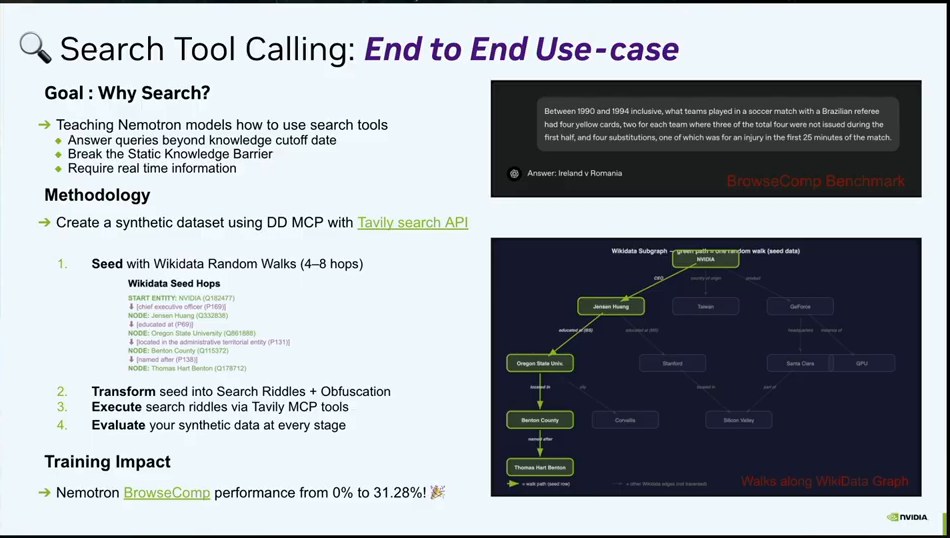
模型的訓練資料有截止日,今天天氣怎樣它答不出來,所以要學會搜尋。他們拿 BrowseComp 當量尺,這是很難的搜尋基準,例如問 1990 到 1994 年間某場有巴西裁判、幾張黃牌的足球賽是哪兩隊,答案是愛爾蘭對羅馬尼亞。〔19:25〕 〔21:28〕
他說題目要讓模型沒辦法從記憶裡直接答,因為只要給 agent 作弊的機會,它就會作弊,直接給答案、不去用搜尋工具。〔24:34〕
五、從 Wikidata 走 4 到 8 步當種子,再改寫成謎題
這次的種子換成 Wikidata 這張知識圖上的隨機路徑。例如從 NVIDIA 走到黃仁勳、再到奧勒岡州立大學、Benton County、Thomas Hart Benton。改寫出來的謎題像是「哪家公司的創辦人,念的大學所在的郡是以 Thomas Hart Benton 命名的」。〔23:30〕 〔24:34〕
步數他抓 4 到 8 步,再多就會偏題,走到「人類」這種沒意義的節點。接著把路徑改寫成謎題、讓 agent 透過 MCP 用 Tavily 搜尋,留下完整的搜尋軌跡,最後評估資料、拿去訓練。種子路徑本身是確定性的演算法產生,agent 只出現在搜尋和產生軌跡那一步。〔25:34〕 〔33:55〕
投影片寫這份資料讓 Nemotron 在 BrowseComp 從 0% 升到 31.28%;他口頭講的是 0 到 30。〔22:29〕
六、5 萬筆種子,最後只留 7,000 筆
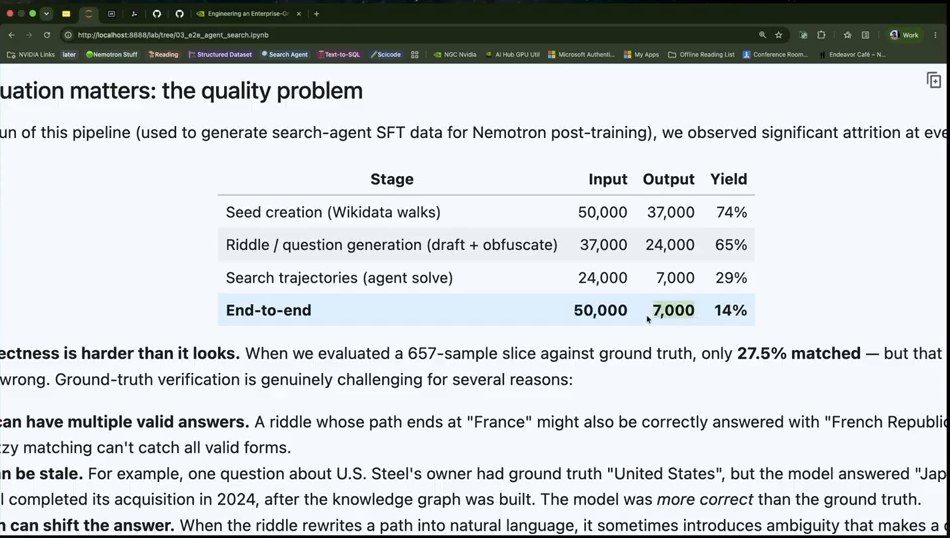
他說自己從 5 萬筆種子開始,最後只剩 7,000 筆高品質的 SFT 紀錄。投影片上的漏斗是:種子 5 萬變 3.7 萬(74%),出題 3.7 萬變 2.4 萬(65%),agent 解題 2.4 萬變 7,000(29%),整體留下 14%。〔39:58〕 〔40:00〕
他的意思是品質比數量重要,多樣性本身就是品質的一個面向。〔40:30〕
七、驗證答案比想像難,連知識圖譜都會過時
有一題問「誰擁有 US Steel」,資料裡的答案是美國,他的驗證也判對;但他去查才發現 US Steel 已經賣給日本公司。種子資料本身也會過時。〔41:04〕
用簡單的比對函式驗證,只有很低的吻合率;他口頭說約 24%,畫面上寫 657 筆樣本只有 27.5% 吻合,而且很多不吻合是因為答案有多種寫法或標準答案過時。他說檢查 100 種問題,只能證明這 100 種問題不存在。〔42:02〕 〔40:00〕
他的做法是疊好幾層:LLM 當評審,再把評審結果送給人工複查,確認評審判得準;搜尋類的題目還可以對即時資訊。〔43:04〕
- 抽一批 LLM 評審的結果給人看,確認評審本身可信。
八、多樣性比數量重要,能用 sampler 就別用 LLM
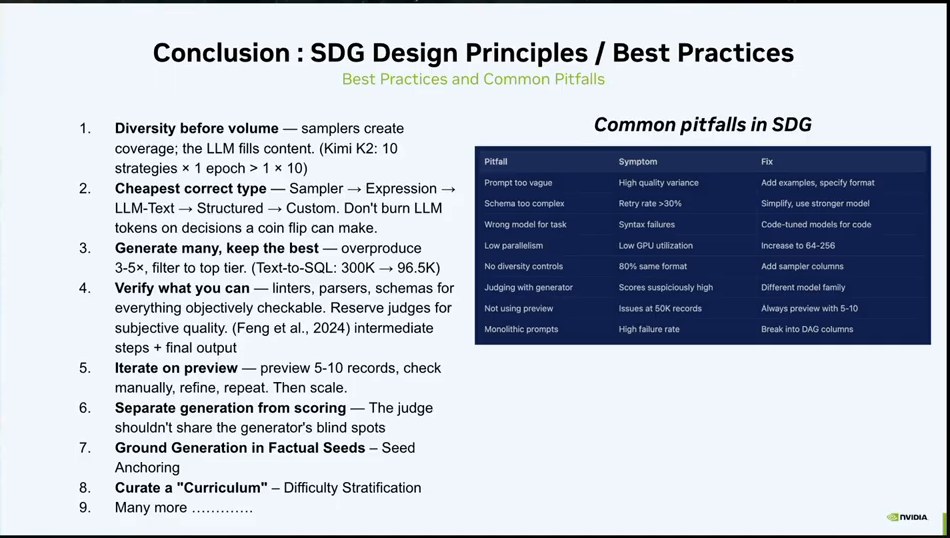
他的幾條做法:多樣性優先於數量,他引 Kimi K2 的論文,10 種策略各跑 1 輪比 1 種策略跑 10 輪好;用最便宜的欄位型別,用 LLM 去擲骰子是浪費;多產再篩;能客觀檢查的就用 linter、parser、schema 檢查。〔45:40〕 〔46:08〕
他說判斷資料好不好最好的方法就是自己看。把產資料的流程寫成程式碼,就能版本控制、分享,別人改一改就能做出自己的版本。〔46:30〕
九、合成資料也能學分布,不用碰到個人資料
他們用人口普查資料和機率圖模型做了一百萬筆「Nemotron Personas USA」合成人物,有年齡、職業、性別等欄位,可以拿來當種子。目的是讓資料符合真實的人口分布,又不用動到任何一個人的真實資料,例如醫療紀錄。〔47:17〕 〔53:30〕
他舉稅務資料的例子:美國 18 歲以下年收入超過 1,000 萬美元的只有大約 7 個人,LLM 自己編的數字會一直回到平均值,所以合成的稅表要對齊真實分布。〔50:12〕
十、同一套做法也能拿去做 RL 和其他任務
問答時有人問能不能用在強化學習。他說可以不產標準答案,只留題目,再搭配 NeMo Gym 寫獎勵函式,用 RL 框架即時跑工具給分。〔36:58〕
他也說蒸餾不一定只能追平老師模型:Nemotron 從 GPT-OSS 蒸餾結構化輸出的資料,在結構化格式的基準上超過了 GPT-OSS;Text-to-SQL 資料讓 BIRD 基準從 26% 升到 41%。這兩個數字都是他口述。〔35:58〕 〔31:51〕
明天就能做的事
資料來源
- Teaching Agents to Search with NVIDIA Data Designer — Dhruv Nathawani(原始影片)|AI Engineer(YouTube)|2026
- NVIDIA-NeMo/DataDesigner|NVIDIA(GitHub)|影片說明附的連結
- Dhruv Nathawani 的 LinkedIn|LinkedIn|影片說明附的連結
※ 工作坊用的 notebook repo 在影片裡是 QR code,說明欄沒附網址,所以這裡不列。逐字稿以 Whisper(medium.en)轉寫 YouTube 原音,對照 en-orig 字幕和投影片校正。圖片截自原片。〔時間〕連結會跳到原片對應段落。文中金額和比例都是講者口述,沒有另外查證。本文為非官方整理,以原影片為準。