[情報] Sentry 的 Greg Pstrucha:別再重講,把糾正寫成 lint rule
如果你用 coding agent 寫程式,常常要對它重講同樣的話,這場 15 分鐘的演講可以直接拿來用。Greg Pstrucha 在 Sentry 做 Seer 背後的基礎建設,Seer 是 Sentry 用來找 bug 根因的 debugging agent。〔0:12〕
一、重講的糾正,compaction 之後就不見了
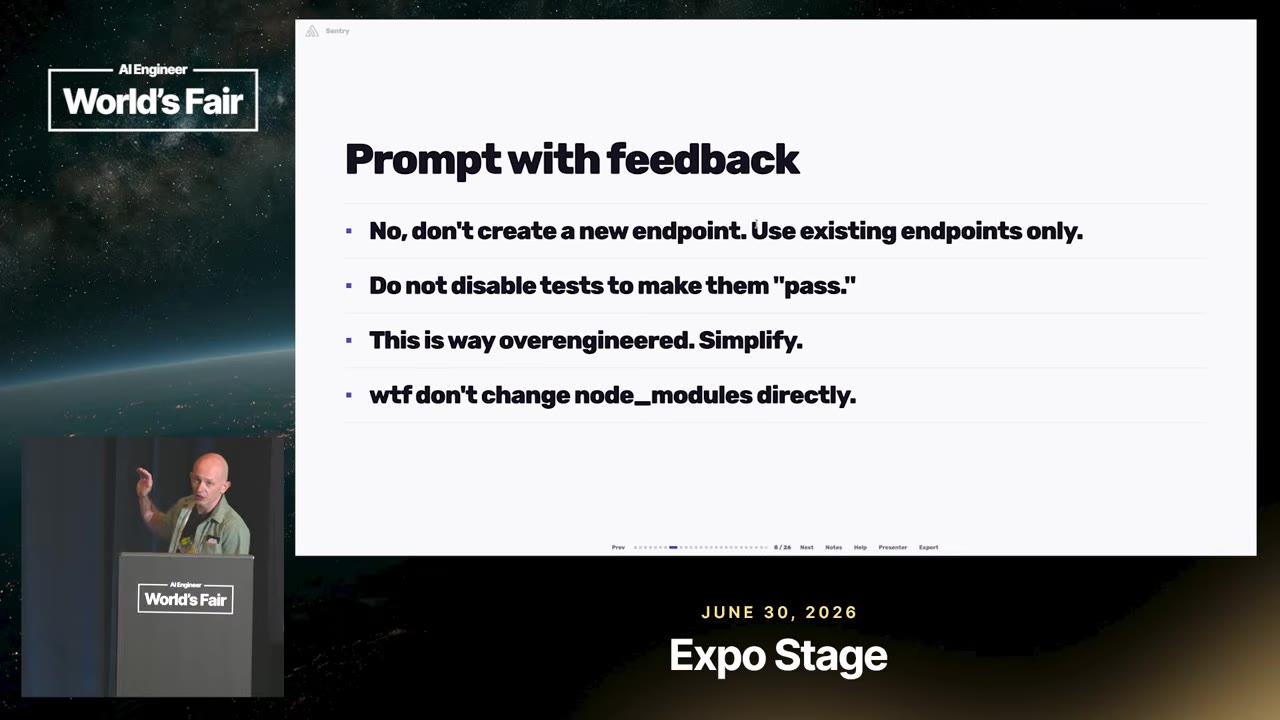
他回頭看 agent 寫的 code,常看到同一批問題:防禦過頭、測試沒在測任何東西、生出沒人需要的 endpoint。〔1:13〕
你糾正它,它說「You're absolutely right」,改一改。五分鐘後 context 被 compaction 壓縮,那段糾正跟著消失,又回到原點,只好再講一次。〔1:58〕
二、測試、嚴格型別、linter 只是基本盤
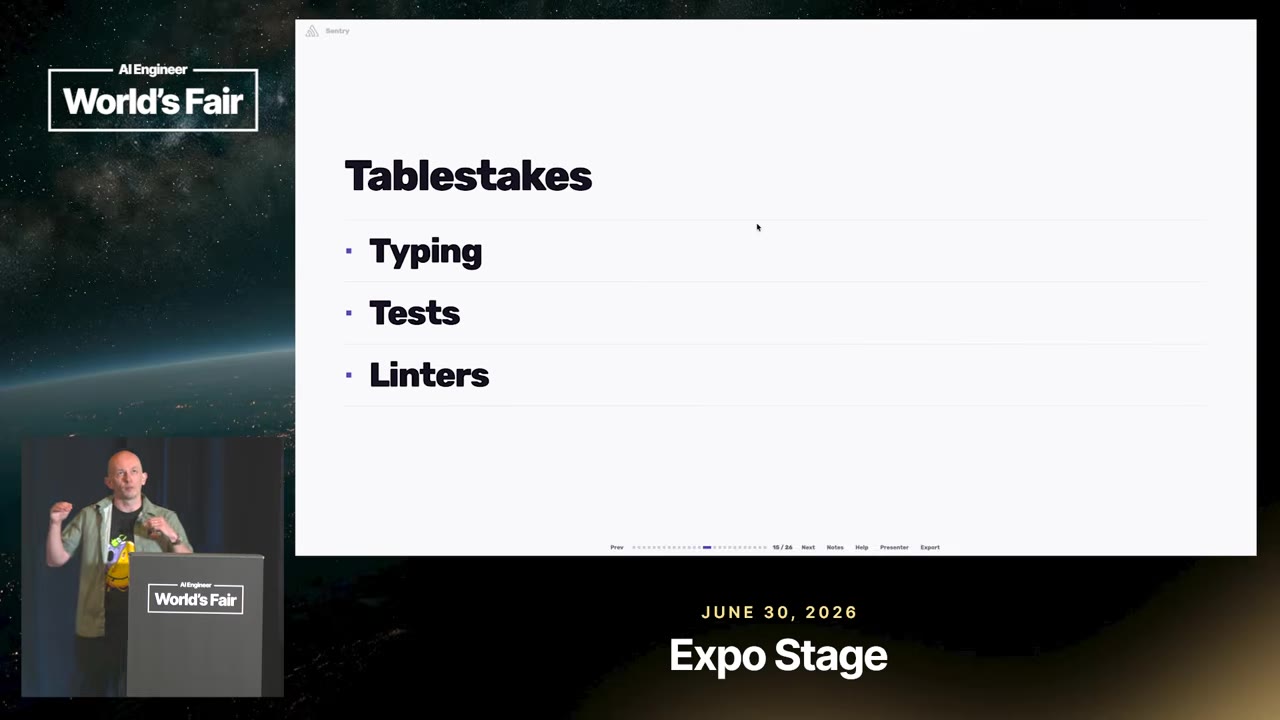
他在確定性這層最在意三件事:測試、嚴格型別、linter。hooks 和 evals 也重要,hooks 負責在對的時間點跑這些檢查。〔2:58〕
光有這三樣還不夠。以型別來說,只開嚴格模式,卻沒禁止那些會帶進你不想要的狀態的寫法,app 裡能表示的狀態,agent 就會把它做出來。
三、有了 agent,寫 lint rule 變便宜了
以前要不要寫一條 linter,得算划不划算:寫起來費工,還要一直維護。如果只是每三週提醒同事一次用設計系統的元件,同事講一兩次就記得,用不著 linter。〔4:08〕
現在寫 code 的是沒有記憶的 agent,同樣的錯會一犯再犯;寫一條新的 lint rule 也變得很便宜,叫 agent 寫就好。兩邊的帳就整個翻過來了。
四、從過去的對話和 review 裡挖規則
他說整場只帶走一件事的話,就是這件。演講完打開你的 agent,叫它翻你過去的對話紀錄、GitHub 上的 review,包括 bot 和同事的意見,找出哪些可以變成高品質、確定性的 lint rule。〔5:23〕
他自己現在就這樣做,還排了固定時間定期再跑,看看有沒有新的漏網之魚。
- 叫 agent 翻過去的對話和 PR review,挑出能寫成 lint rule 的糾正。
- 排個固定時間定期重跑一次。
五、lint 也能管 API 跟 schema 有沒有對上
簡單的 lint rule 大家早就在寫,像禁止 console.log、強制用設計系統元件。他說有了 agent,可以做得更進一步。〔5:58〕
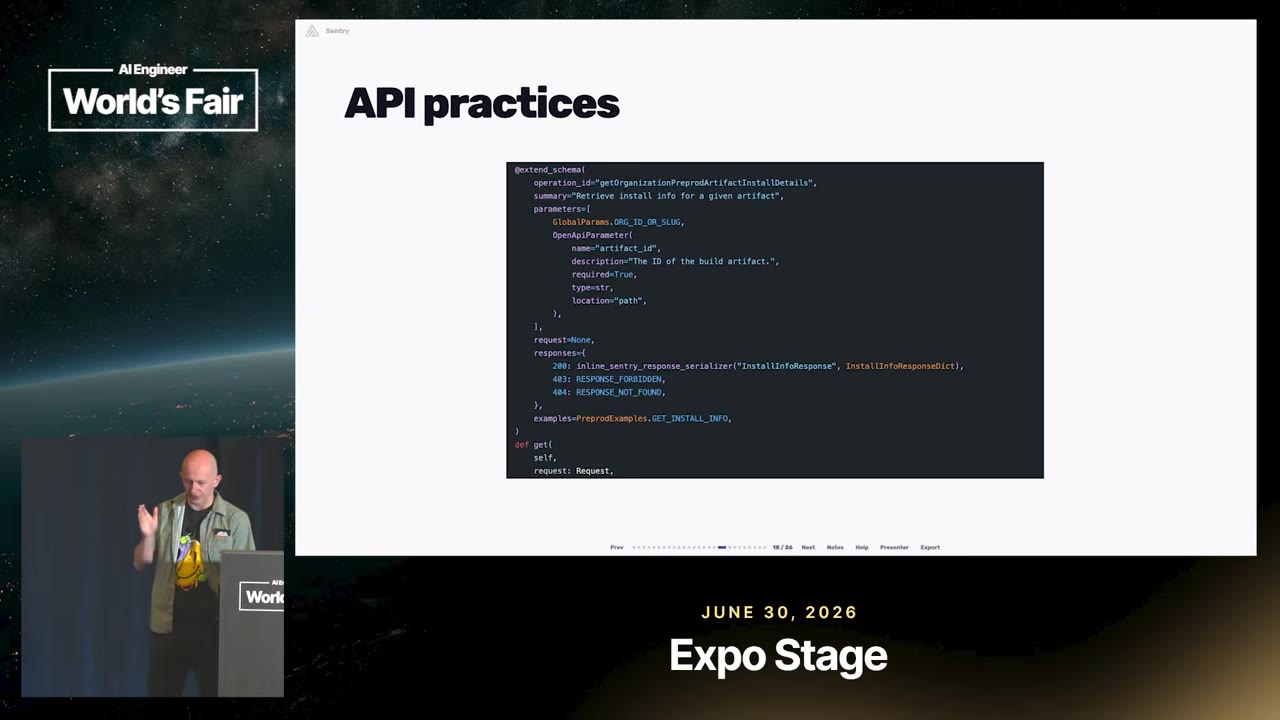
Sentry 是老 codebase,用 Django 和 DRF,沒有全面嚴格型別,OpenAPI schema 寫的和 API 實際做的常常對不上。他們加了幾條規則:endpoint 函式一定要回傳 response 型別,裡面不能有 any;endpoint 一定要掛上產生文件的 schema decorator;產出的型別要跟 OpenAPI schema 宣告的一致。API 跟文件就比較同步了。〔6:43〕
六、agent 會鑽 lint 的漏洞,要一路補
Seer 要常常呼叫 Sentry API,他們用 skill 教它怎麼呼叫,skill 裡附了程式碼範例。第一次大量生成這些 skill 時,很多範例是 agent 編出來的,Seer 的準確度明顯掉下來。〔7:52〕
於是他們寫了一條 linter:skill 裡的 code block 要抽出來做型別檢查、要能在沙盒裡跑、要符合 Sentry 的 OpenAPI schema。結果 agent 重跑時的第一反應是直接刪掉 code block;規定一定要有範例,它就把範例放回去但拿掉反引號;規定長得像 code 的都要放進 code block,它就改用文字描述 API,順便寫出 URL;他們再把 URL 也 lint 掉。〔9:17〕
這樣打地鼠打了一陣子,最後 skill 跟 OpenAPI schema 保持同步,成本也不高。API 改了,不用再一份份追著改 skill。
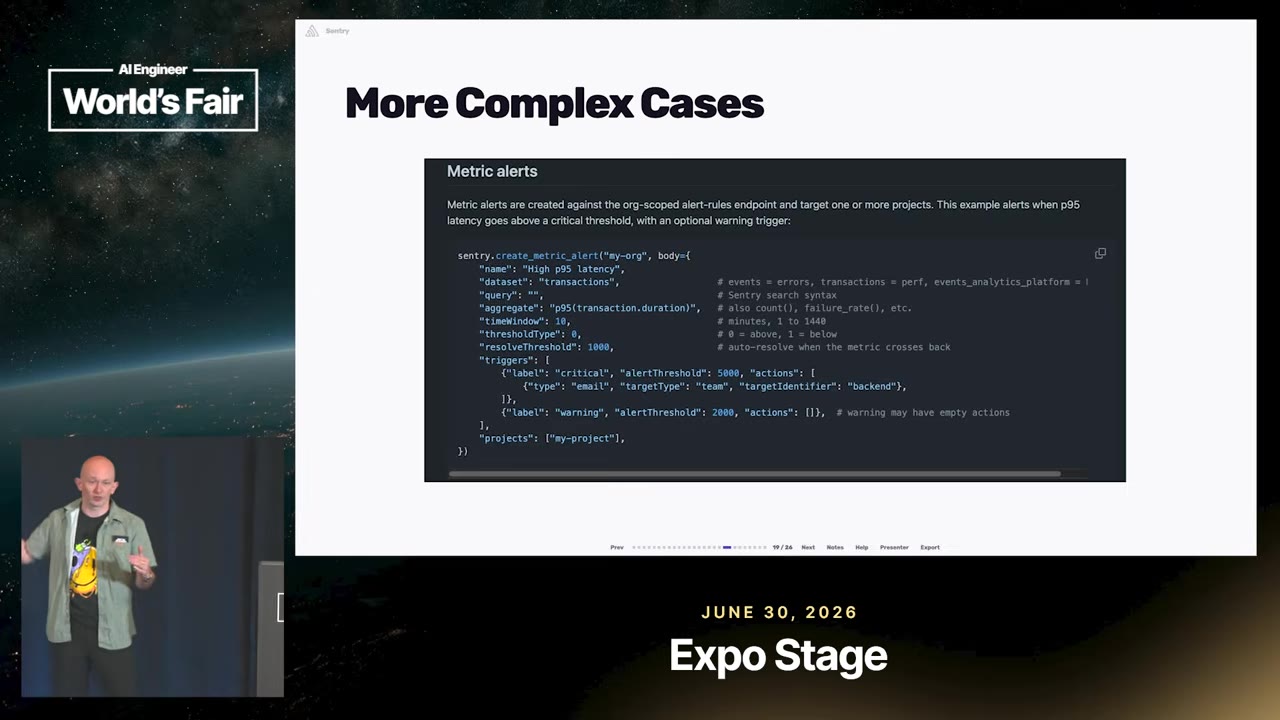
工具方面用你本來就在用的就好:ESLint、Oxlint、Flake8、Clippy、ast-grep。ast-grep 不分語言,可以統一工具。也有新工具像 Taskless,用英文寫你要 linter 擋什麼,再由它生出 linter。他最後還是那句:直接叫 agent 幫你寫 linter,成果會讓你意外。〔10:37〕
- 用現有的 ESLint、ast-grep 這類工具,叫 agent 幫你寫自訂規則。
七、lint 擋不了的,交給政策和 review agent
有些規則沒辦法用確定的方式寫出來。例如一個只有三個狀態的 state machine,一個小 PR 就把它撐到十個;硬訂「最多四個狀態」,他說那全是瞎掰的。這是靠工程經驗判斷的事。〔11:27〕
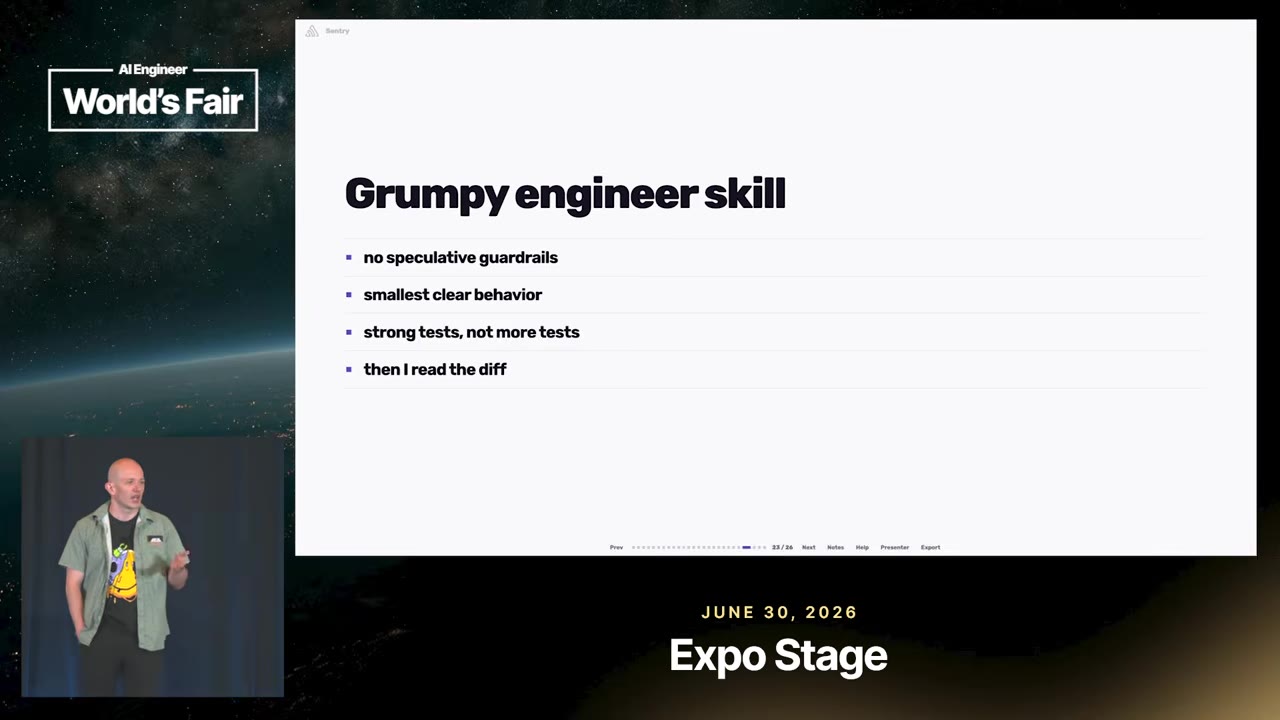
他的做法是替 repo 寫政策,像是測試不要多、要強,code 不要防禦過頭。他寧願讓型別系統根本表達不出不想要的狀態。接著做了一個叫 Grumpy Engineer 的 skill,內部叫 Garfield:每條政策各派一個 subagent,要嘛給意見、要嘛放行,一直循環到全部放行,他才開始讀 code。〔12:22〕
他說目的還沒到取消 code review,是把下限墊高,讓他 review 時不用一直講最基本的問題。
- 把你對品質的要求寫成 repo 裡的政策。
- 讓 review agent 照每條政策檢查、循環到放行,你再看 diff。
八、給 agent 一個數字,它就會去刷那個數字
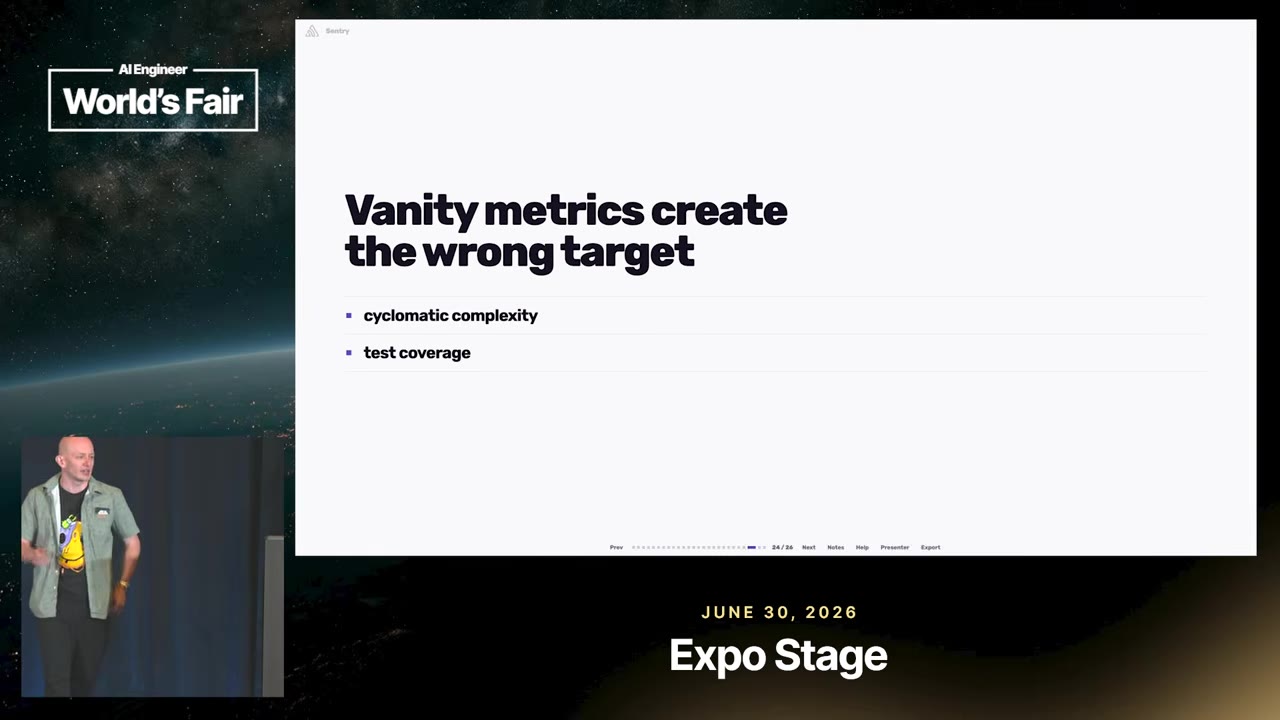
他試過用數字來量品質,像 cyclomatic complexity(看分支多少、呼叫多深)和測試覆蓋率。〔14:07〕
他有專案覆蓋率衝到接近 100%,測試卻爛到只是在比對某段固定字串,什麼有用的東西都沒量到,還給人一種很安全的錯覺。
- 別把測試覆蓋率這類數字當成 agent 的目標。
明天就能做的事
- 叫 agent 翻過去的對話紀錄和 PR review,挑出能寫成 lint rule 的糾正,並排固定時間重跑。〔5:23〕
- 用現有的 linter 工具,讓 agent 幫你寫自訂規則。〔10:37〕
- 把品質要求寫成 repo 的政策,讓 review agent 照政策檢查、循環到放行再看 diff。〔12:22〕
- 別把覆蓋率這類數字交給 agent 當目標。〔14:07〕
他最後的一句話:make the repo remember,讓 repo 替你記住。〔15:22〕
資料來源
- Stop Prompting — Greg Pstrucha, Sentry(原始影片)|AI Engineer(YouTube)|2026
- Sentry Seer 產品頁|Sentry|影片說明附的連結
- Sentry 官網|Sentry|影片說明附的連結
- Greg Pstrucha 的 LinkedIn|LinkedIn|影片說明附的連結
- Sentry 的 X 帳號|X|影片說明附的連結
※ 逐字稿以 Whisper(medium.en)轉寫 YouTube 原音,對照 YouTube en-orig 字幕與投影片校正。文中投影片截圖取自原影片,〔時間〕連結會跳到原片對應的段落。本文為非官方整理,以原影片為準。