[情報] Lauren Tan 睡醒就有 20 個 PR 合進 main:她先教 agent 自己驗證,再把規矩寫進 CI
Lauren Tan 網路上叫 poteto,做了 pstack,一個裝滿 skill 的 Cursor plugin;Cursor 是 AI 寫程式工具,她在那裡做 agents window 和 Grok Bot。Grok Bot 讓你建立各有身分的 agent,在像傳訊息的介面裡指揮它們(影片 32:05)。這場一小時的線上 workshop,她從自己怎麼開始信任 agent 講到 Grok Bot 的 CI 長什麼樣(影片 0:55)。
適合還在一兩個 agent 旁邊盯著看、想多開幾個又不放心的工程師,也適合在算「先燒 token 整理 codebase 值不值得」的技術主管。
一、信任要一格一格爬,沒辦法直接跳到一百個 agent
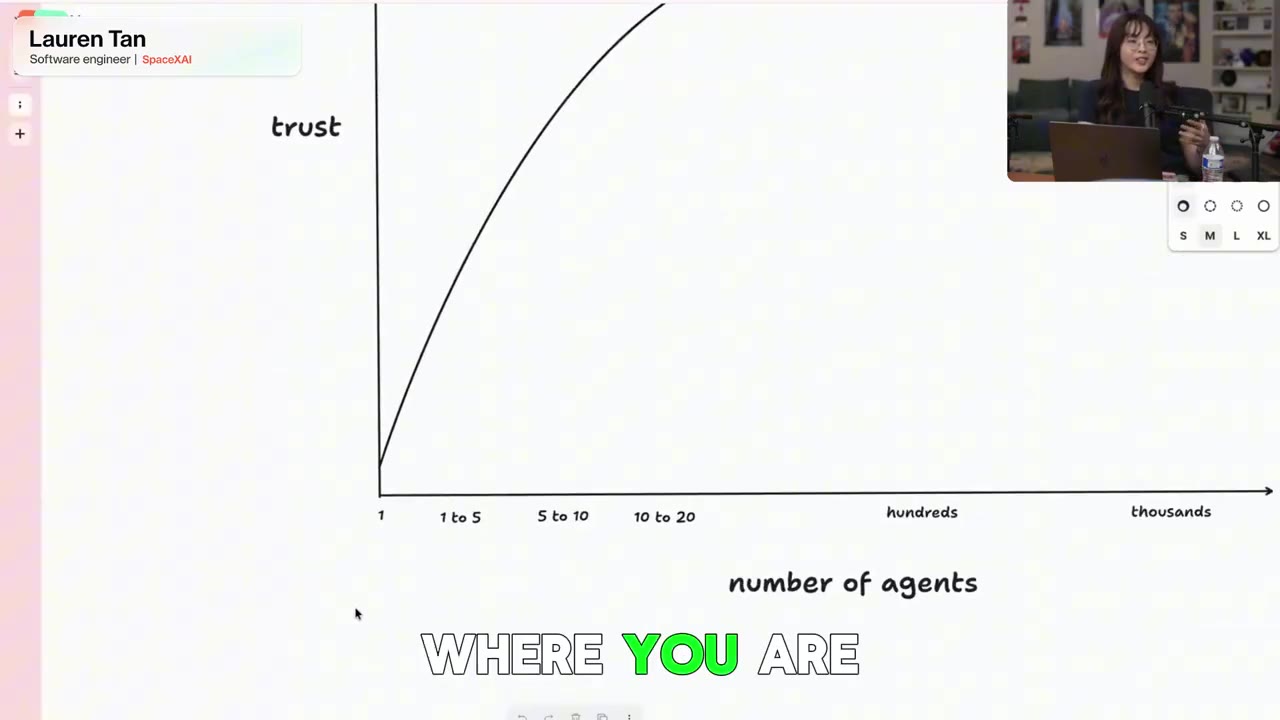
Lauren 畫了一條信任曲線:橫軸是同時跑幾個 agent,從 1 個、1 到 5 個、一路到幾百、幾千個,縱軸是你有多信任它們(影片 2:06)。
一年前大家多半卡在左下角:手上一兩個 agent,每個輸出都盯著看、一直下 prompt。她說這樣根本平行不起來,連一個 agent 的結果都不信,不可能開一百個(影片 3:04)。她拿帶團隊比:主管不信任組員,就只能一直在旁邊看,變成微管理(影片 1:46)。
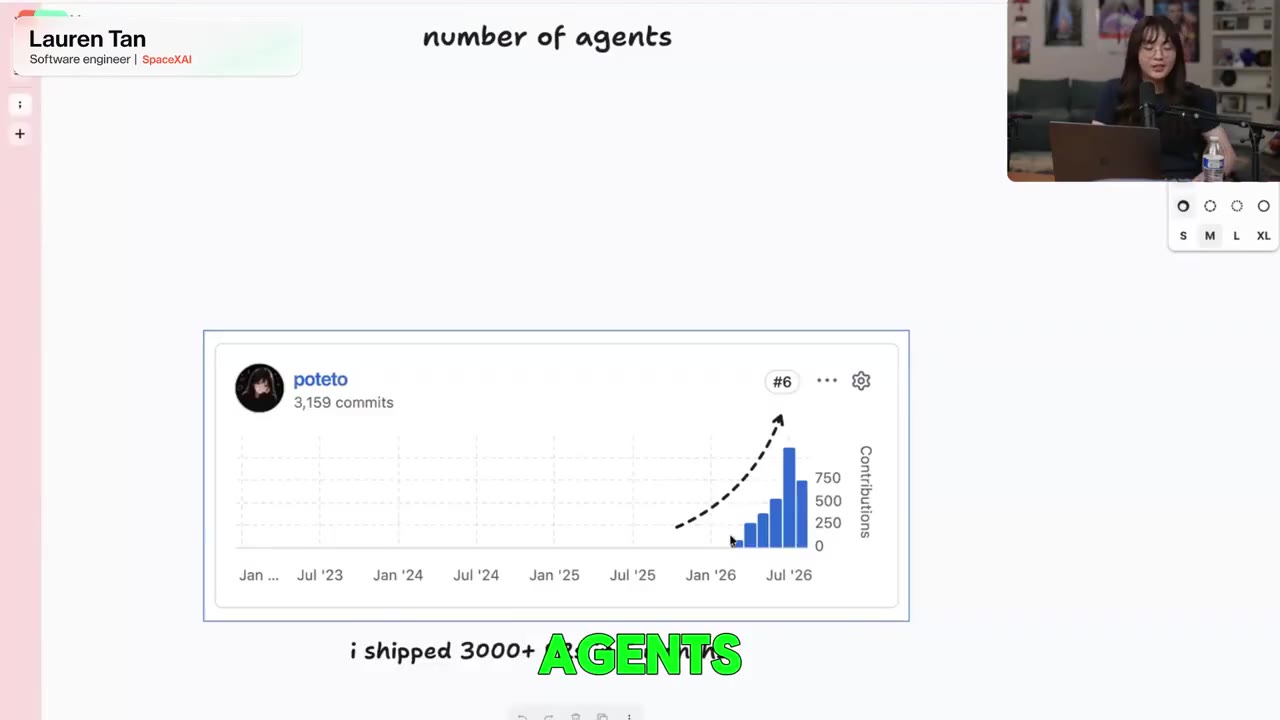
她自己花了五個月往上爬。剛加入 Cursor 的第一個月幾乎沒產出,上個月出了 1,000 個 PR,這個月到 12 號已經快 800 個(影片 4:46)。錄影當天早上她一醒來,已經有大約 20 個 PR 被 agent 自己合進 main,她是在 main 上回頭看,看完覺得沒問題(影片 3:32)。
這些數字都是她自己講的,影片裡沒有其他佐證;她也承認大家一定會懷疑這麼多 code 有多少是好的(影片 5:06)。
二、讓 agent 自己把程式跑起來驗證,你才不用當人肉測試
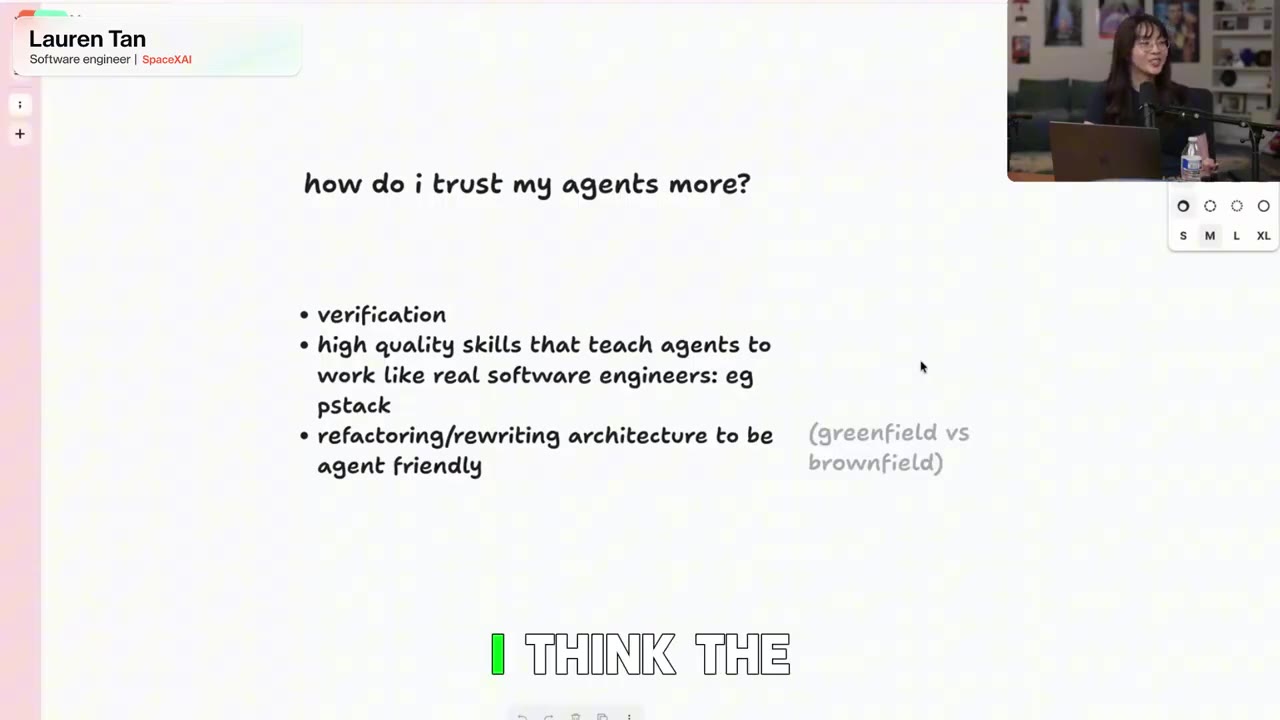
她認為工具箱裡最重要的是驗證能力:agent 能真的執行程式、抓 CPU trace 和 heap snapshot、開 iOS 模擬器,使用者怎麼碰到你的 app,agent 就怎麼碰(影片 5:45)。這不保證 code 寫得好,但至少寫得對,信任就是從這裡開始(影片 6:20)。
她的例子是剛進 Cursor 第一週,被拉去救 agents window 的效能,離上線只剩一週。她自己開 Chrome DevTools 錄 trace、截圖丟給 agent,agent 很有自信地指出兇手,修完才發現猜錯,來來回回非常慢(影片 7:25)。
沒有驗證,流程就是 agent 寫完、你開本機 build 試、把截圖和 console 錯誤貼回去,一直重複,完全沒辦法平行(影片 8:31)。她做的第一個 skill 叫 control glass,Glass 是 agents window 的內部代號:教 agent 透過 Chrome DevTools Protocol 這套用程式遙控瀏覽器的介面,去操作 Electron 或網頁 app,iOS 則用 Apple 的模擬器工具。她說程式本身不難,叫 agent 幫你寫就有(影片 9:05)。
要從哪裡開始,她建議先在本機做,讓 agent 把 app 開起來,你在旁邊看它怎麼操作、呼叫哪些 API(影片 23:55)。
- 寫一個 skill,讓 agent 能自己啟動你的 app、操作畫面、抓 trace 或錯誤訊息。
- 先在本機跑,看清楚 agent 怎麼跟 app 互動,再往下走。
三、給 agent 一張功能地圖,連「???」的回報都查得到
agent 會操作 app 之後,新問題是它不知道 app 裡有什麼。有人說「左邊側欄很卡」或「右邊 PR 分頁壞了」,agent 就在 code 裡亂翻,找不到功能在畫面哪裡,等於沒用(影片 10:08)。
她的解法是在 skill 裡放一份 feature map:每個功能有哪些子功能、使用者從哪裡點進去、有哪些快捷鍵,連透過 CDP 選取元素要用的 DOM 屬性都寫好(影片 12:35)。
Cursor 內部有個 Slack 頻道收 agents window 和 Grok Bot 的回饋,很多回報品質很差,常常只有一張截圖加「???」。有了地圖,agent 才有辦法從這種回報找到對應的功能(影片 11:52)。
她寫的 plugin pstack 裡有 create-verification-skill,會先讀你的 code 建出第一版地圖;另外有 maintain-verification-skill 負責更新(影片 11:24、影片 13:06)。
- 替你的 app 寫一份功能地圖:功能在哪、怎麼點到、選取元素用什麼屬性。
- 用 pstack 的 create-verification-skill 產生初版,再用 maintain-verification-skill 維護。
四、agent 每犯一種錯,就寫成一個 skill
pstack 不是一開始就規劃好的。名字裡的 P 是 potato,取笑 Y Combinator 執行長 Garry Tan 的 GStack,兩人同姓但沒有親戚關係(影片 13:42)。她從 control glass 開始,接著寫了一個叫 how 的 skill,之後每看到 agent 的一種失誤就補一個(影片 14:10)。
how 的由來是她發現 agent 很有自信地說「一定是這裡壞掉」,打開工具呼叫一看,它根本沒讀該讀的那段 code(影片 14:49)。她用帶新人來想:一個很會寫程式、但完全不懂業務的新同事,你怎麼讓他上手?寫 skill。skill 就是一份 markdown,把知識和做事方法交給 agent(影片 15:35)。
所以她的 skill 很多都是針對壞習慣:別亂猜、去讀 code、多用 subagent 查(影片 16:40)。要找出這些毛病得花心思觀察,她說要很會當「後座駕駛」,像結對寫程式時看同事寫 code 一直想問「你為什麼不這樣做」。打開工具呼叫、讀 code、讀 agent 的思考過程,就看得到它在哪裡犯傻(影片 20:05)。
她把工程師現在的角色比成主廚,工作是設計廚房、分派工作給每個站(影片 22:40)。
- 打開 agent 的工具呼叫和思考過程,找出它在哪裡亂猜或沒讀 code。
- 每找到一種失誤,就寫成一個 skill。
五、skill 也要考試:跑 eval,用 /loop 磨到滿分
skill 寫了要知道有沒有用。她把 eval 當成 agent 的單元測試,不需要特別的框架,自己就能做(影片 17:43)。
pstack 的 potato mode 裡有一份 Eval playbook:主 agent 先訂評分標準,再開很多 subagent 去做題。每個 subagent 有自己的資料夾,名字刻意取得看不出在受測,因為 agent 發現自己在被評分時會改變行為(影片 18:30)。Cursor 支援很多模型,同一個 skill 可以換不同模型各跑一輪(影片 19:33)。
分數可以往上爬。除了主 agent 打分,還可以找另一個模型當評審,交叉檢查有沒有偏心;再用 Cursor 的 /loop 指令叫 agent 反覆跑,直到每項都 10 分(影片 21:30)。她的 control skill 就是這樣磨出來的,過程幾乎不用她插手,但一開始也花了很多輪(影片 21:55)。
- 每次改 skill 就跑一次 eval,受測的 subagent 不要讓它知道在考試。
- 找另一個模型當評審,再用 /loop 讓它一路跑到滿分。
六、本機信得過了,再交給雲端 agent 替全隊做事
她現在幾乎全押在 Cursor 的雲端 agent 上。驗證 skill 一旦設好,好處就不只是你一個人:整個團隊、整間公司都能用(影片 24:18)。
例子是一個叫 Benny 的 agent。它接收所有 bug 回報,在雲端開一台自己的桌面、跑 Cursor,用同一套 control skill 試著重現。有一次它重現了 bug,同時發現 main 上已經修好,她只要再出一版就好,省掉自己陪 agent 查一小時(影片 25:20)。
她特別提醒,如果你還在只開幾個 agent 的階段,不要直接跳去開幾百、幾千個雲端 agent,只會浪費很多 token、花很多錢(影片 26:48)。主持人 Colin 幫大家整理的順序是:先建驗證,在本機信得過了,再讓雲端 agent 自己接 bug 回報、交回 PR,最後才是自動合併(影片 27:10)。
- 本機的驗證 skill 穩了,再把它接到雲端 agent,讓它自動接 bug 回報、試著重現。
七、新專案最該一開始就上硬規矩
她替「重寫」說話,但看情況。大公司的舊系統其實狀況不錯:她在 Meta 時,幾萬個工程師同時往一個 monorepo 推 code,品質沒有大家想的好,她開玩笑說 AI 垃圾 code 出現之前,就有人類垃圾 code 了(影片 30:50)。這種公司的框架、慣例、權限限制,本來就是為了讓能力最弱的人也不會闖禍,例如不讓實習生刪掉正式資料庫,所以 agent 進去也有護欄(影片 31:35)。
風險最大的是全新專案。Grok Bot 一開始是 vibe coding 快速做出來的原型,沒有人讀 code;agent 接到任務就用最方便的方式解,久了 codebase 會失控,人看不懂,agent 寫出來的東西又都是抄捷徑(影片 32:20)。
她後來花了 600 多個 PR,把 Grok Bot 整個重構到新架構,內部代號 Dune,可以想成給 Electron app 用的 Next.js,專門設計給 agent 寫(影片 34:19、影片 38:00)。每個功能的 code 都放在同一個資料夾,agent 做 onboarding 功能就待在那個資料夾裡,八成的工作都不用跑出去(影片 43:10)。
她的設計原則是把捷徑變成正解:agent 本來就愛抄最快的解法,也愛照抄現有寫法,那就讓最快的寫法剛好是對的(影片 43:52)。Dune 不會開源,她說它比較像一組原則,可以截圖叫 agent 照著做一套(影片 44:18)。
- 新專案一開始就把架構慣例定死,讓 agent 最順手的寫法剛好是對的寫法。
- 同一個功能的 code 放在同一個資料夾。
八、會讓 CI 變紅的規矩,才擋得住 agent
Dune 的 CI 對人來說很煩,什麼都檢查,但煩的部分 agent 會吸收(影片 35:10)。例如 React 裡最容易踩雷的 useEffect,就直接禁用,用了 CI 會失敗(影片 38:36)。她也禁止寫 code 註解,因為 agent 寫的註解九成九在講跟程式無關的歷史,例如「Lauren 說永遠不要這樣做」,其實她只是在講那個 PR 爛(影片 39:11)。
效能是另一個例子。agents window 常常效能倒退,因為 Electron 的主執行緒和畫面執行緒分得不乾淨,重的程式一不小心就跑到負責畫面的那邊。想要 60 fps,每一格只有 16 毫秒,超過就卡(影片 40:40)。Grok Bot 就把兩邊放在不同目錄,CI 檢查相依圖,禁止互相 import(影片 41:48)。
| 層 | 她舉的例子 | 擋得住嗎 |
|---|---|---|
| 架構和慣例 | 功能資料夾、固定的寫法、擋掉不該有的 import | 最強,agent 會照抄現有寫法 |
| 靜態分析 | CI 檢查、lint、編譯器診斷 | 硬,會讓 CI 變紅 |
| rules、Bugbot、skill、風格指南 | Bugbot 是 Cursor 在 CI 上跑的 code review 工具 | 軟,agent 可能忘記或沒每次照做 |
只靠軟的那幾層,codebase 遲早變成垃圾,所以她會疊著用,但不當成唯一防線(影片 45:25)。她也舉 Rust 為例:編譯器夠嚴格,只要不讓 agent 寫 unsafe,能編過大概就能動(影片 46:06)。
最糟的狀態是所有規矩都靠人在 code review 時留言。每次你要在 PR 上提醒同一件事,就該當成警訊,想辦法改成 lint 規則、CI 檢查,或乾脆讓這類問題不可能發生(影片 47:05)。
- 下次在 PR 上留同一種意見之前,先想能不能改成 lint 規則或 CI 檢查。
- agent 常寫錯的模式,直接在 CI 禁掉。
九、PR 拆小,出事才找得到、退得掉
她的 PR 沒有大小上限,大概從 50 行到 1,000 行都有(影片 36:45)。但她會要 agent 把工作拆成好幾個 PR:git 歷史是很好的上下文,每個 PR 只做一件小事,出 bug 時比較好找、好退,不會埋在一個 40,000 行的 PR 裡(影片 37:12)。
- 要 agent 把工作拆成多個小 PR,每個只做一件事。
十、前期燒的 token,換整個團隊都能安全出貨
有觀眾問一般人 token 沒那麼多,做得到嗎?她先承認自己在 token 無上限的 AI 實驗室工作,不能說大家都該照她的方式做,但她認為不燒大錢也做得到(影片 48:25)。
她把它當 ROI 來算:重構 codebase、補上這些檢查,前期確實很花 token;另一個選項是請人。她說換成自己一個人、沒有 agent,這套框架加重構加測試要做好幾年,而她的薪水不低(影片 49:45)。她的說法是,把 codebase 整理到連最笨的 agent 都能寫好,比請人划算,而且到了那一步,不是頂規的模型也寫得很好(影片 50:45)。
最大的回報在別的職務。她說規矩到位後,PM、設計師、甚至做 GTM 的人都能在 Grok Bot 上加功能,她不用半夜擔心有人合進效能倒退(影片 34:50)。PM 傳來一個修好的 bug,她看完覺得完全沒問題就核准了(影片 54:50)。她把 Grok Bot 形容成非技術人員的 Cursor 時刻:介面像 iMessage,PM 可以讓一個 agent 整理她昨晚做了什麼(影片 53:50)。
她也順帶提到當天剛發表 Grok 4.6,她說「希望沒講錯」,每個 token 的價格應該跟 4.5 一樣(影片 51:30)。
十一、標題裡的「20+ agents」「85%」,演講裡沒講
這支影片是 Ai insider 頻道的上傳,畫面上壓了大字幕。標題和說明欄寫她用 /loop、/goal 跑 20 多個 Grok Bot agent、SpaceXAI 有 85% 工程師各跑 10 個以上,還有一個 Chief of Staff agent(影片說明)。我們對過逐字稿,演講裡沒有這些說法;/loop 只在講 eval 時出現。
畫面從 9:05 左右開始停住不動,聲音還在,所以後半段提到的投影片(例如規矩分層那張)看不到,上面的表格是照她口述整理的。她的名牌寫 SpaceXAI 軟體工程師,演講中則說自己五個月前加入 Cursor,談模型成本時把 Cursor 和 SpaceX AI 並列(影片 51:45)。
明天就能做的事
- 寫一個 skill,讓 agent 能自己啟動 app、操作畫面、抓 trace,先在本機跑。
- 替 app 補一份功能地圖,或用 pstack 的 create-verification-skill 產生初版。
- 打開 agent 的工具呼叫和思考過程,把看到的每種失誤寫成 skill。
- 每次改 skill 跑一次 eval,換另一個模型當評審,用 /loop 跑到滿分。
- 本機穩了,再把驗證 skill 接到雲端 agent,自動重現 bug 回報。
- 新專案一開始就定死架構慣例,同一功能放同一資料夾。
- 在 PR 上重複留的意見,改寫成 lint 規則或 CI 檢查。
- 要 agent 把工作拆成小 PR。
資料來源
- SpaceXAI engineer, Lauren Tan: I'm running 20+ GrokBot agents with /loop, /goal, inside pstack,YouTube/Ai insider,2026(上傳 2026-09-11,含章節與留言)
※ 逐字稿以 Whisper(medium.en)轉寫,並對照 YouTube 原音字幕(en-orig)校正。內文時間戳都連回原片。影片 9:05 之後畫面停格,後半段投影片內容依口述整理。非官方圖文整理。