[情報] Lee Robinson 史丹佛講課:always-on agent 是怎麼做出來的
這堂課在拆 Grok Bot 這類常駐型 agent 的架構,從伺服器、佇列、工具設計講到 prompt cache 和記憶。在做 agent 產品、寫 harness,或想知道這類產品背後怎麼運作的人,值得看。
一、模型變強以後,介面反而變簡單
Lee 把開發者用 AI 分成四個時期:從 ChatGPT 複製貼上程式碼;在終端機裡讓 agent 改檔、跑指令;給 agent 專用 app、同時跑好幾個,但每個指令還是要人批准;到現在的常駐 agent,有自己的電腦和記憶,你睡覺時它還在做事。
以前你得排隊等 agent 做完才能下下一個指令。現在可以隨時插話,像跟朋友講話那樣一句接一句,模型聽得懂兩句之間的關係。
寄信、發 Slack 這類動作,則交給另一個模型做 auto review,一條條檢查指令。他說這比人盯著幾百條 shell 指令按批准還安全,盲測時模型多半檢查得比人好。
所以介面收斂成「傳訊息」。大家都會傳訊息,這類產品才會一下子冒出這麼多。
二、常駐 agent 平常在睡,被事件叫醒才做事
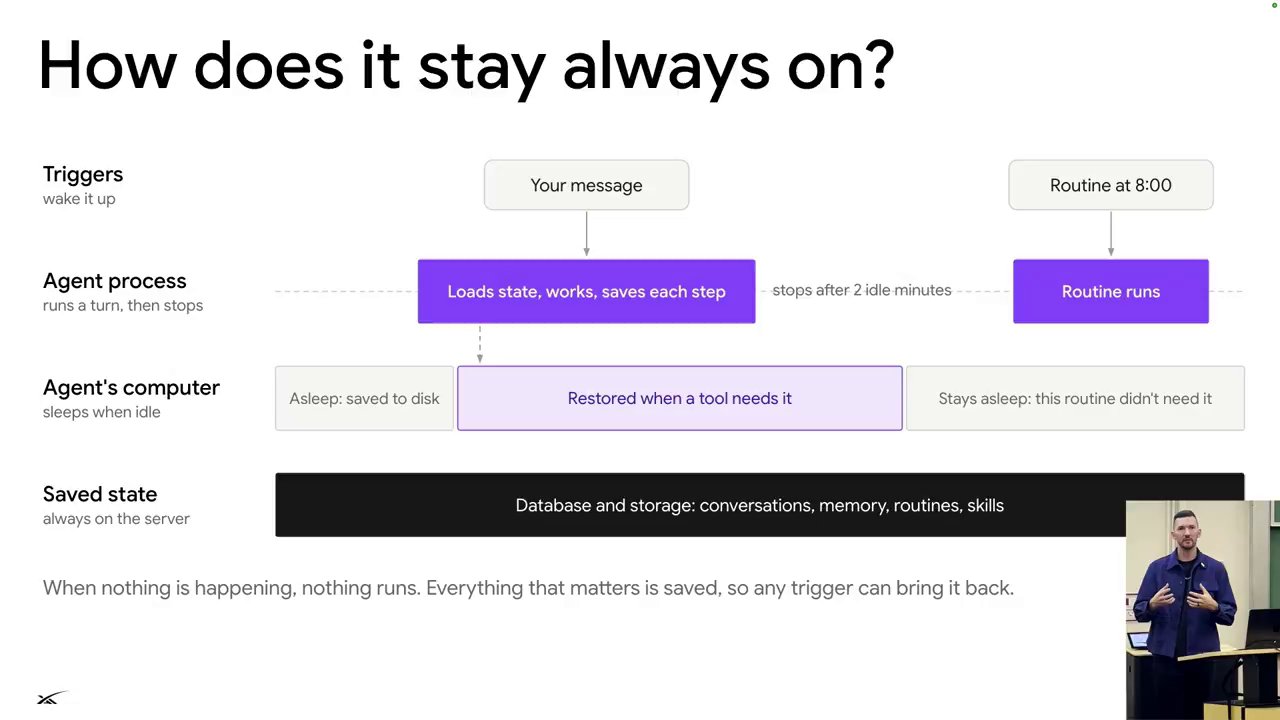
沒事的時候,伺服器上的 agent 和它用的電腦都在睡。有人傳訊息、到了排程時間、Slack 有人 tag、有會議要參加,才會把狀態載回來開始做事。用完再讓電腦睡回去,因為世界上沒有那麼多電腦能讓每個人一直開著。
對話紀錄、記憶、排程這些狀態都存在資料庫。各種觸發先進一個 router 去重,再決定要不要塞進對話。
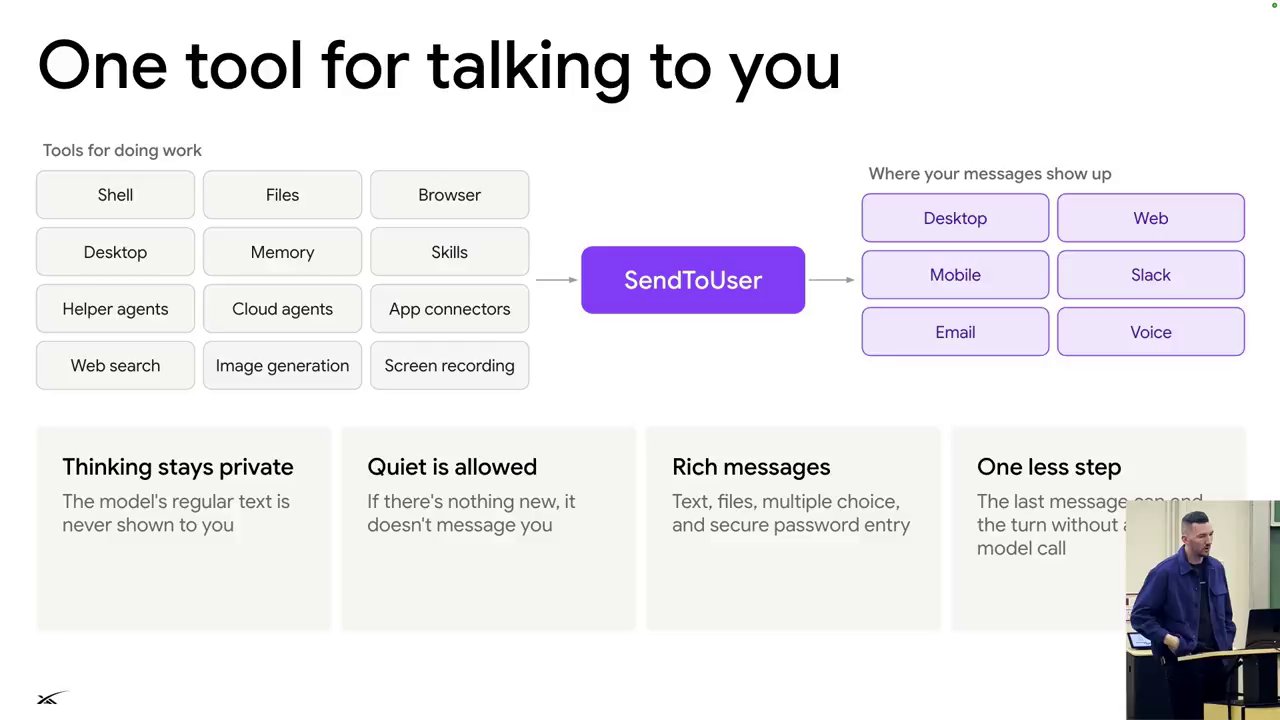
它還要判斷要不要吵你。同事每做一點進度就跑來報告會很煩,常駐 agent 也一樣,很多時候安靜做完、該報告時再說就好。
agent 用的電腦是一台 Firecracker 虛擬機,好處是隨時能存快照、關掉再開起來。上面有檔案、能跑指令、能開瀏覽器,跑好幾個 bot 時可以各自用不同的虛擬桌面,你也能連進去即時看它在做什麼。
三、agent loop 放伺服器,而且要能從中斷的地方接著跑
他們走「瘦客戶端、胖伺服器」。agent 程式要更新時,推伺服器比推 App Store 快;轉錄、生圖這類重運算在伺服器上也比較快。最關鍵的是 agent loop 不能放在虛擬機裡,不然虛擬機就不能單獨關掉。例如 Linux 有零時差漏洞要重建虛擬機,不該連整個 agent 一起停擺。
底層要用 durable workflow,不是一般的 job queue。agent 做到第三步時機器掛了,一般佇列重啟要從第一步重來;durable workflow 每一步都有紀錄,重試會從第三步接著做。他們用開源的 Temporal,不自己從頭造。
訊息也有優先順序。你直接傳給自己的 bot,會打斷正在跑的迴圈優先處理;群組、Slack 討論串或背景排程就排到後面。短時間連來三四則,可以併成同一輪處理。
- agent 的長任務改用 durable workflow(例如 Temporal),失敗重試時從中斷的那一步接著跑。
四、客戶端只需要一個工具:SendToUser
Grok Bot 的客戶端和伺服器之間只有一個工具,就是 SendToUser。跑 shell、讀檔、叫雲端 agent、錄螢幕這些重的工具全在伺服器上。不管客戶端是手機、桌面 app、email 還是 Slack,都只靠這一個工具來回。
客戶端拿到訊息後,自己決定怎麼呈現:要登入就跳登入表單、接 1Password;要付款就接 Stripe Link 這類服務;寄信、發 Slack 這種收不回來的事,先給你一份草稿編輯、批准;有時候按個 emoji 就好,不必回訊息。
安全這塊他也提了:信箱裡的信可能是釣魚信,這類外部內容不能當成使用者的指令;收不回來的動作要先問人;密碼要靠產品流程擋在對話外面。
五、能自己查就別問人,從最便宜的方法試起
工具也要省 context。每裝一個 Google Drive、Gmail、YouTube 的 MCP server,工具名稱、schema、說明就佔掉一塊,留給對話的空間越來越少。現在常見的做法是每次只放工具名稱,模型要用時再去讀細節,有人叫它 tool search tool。
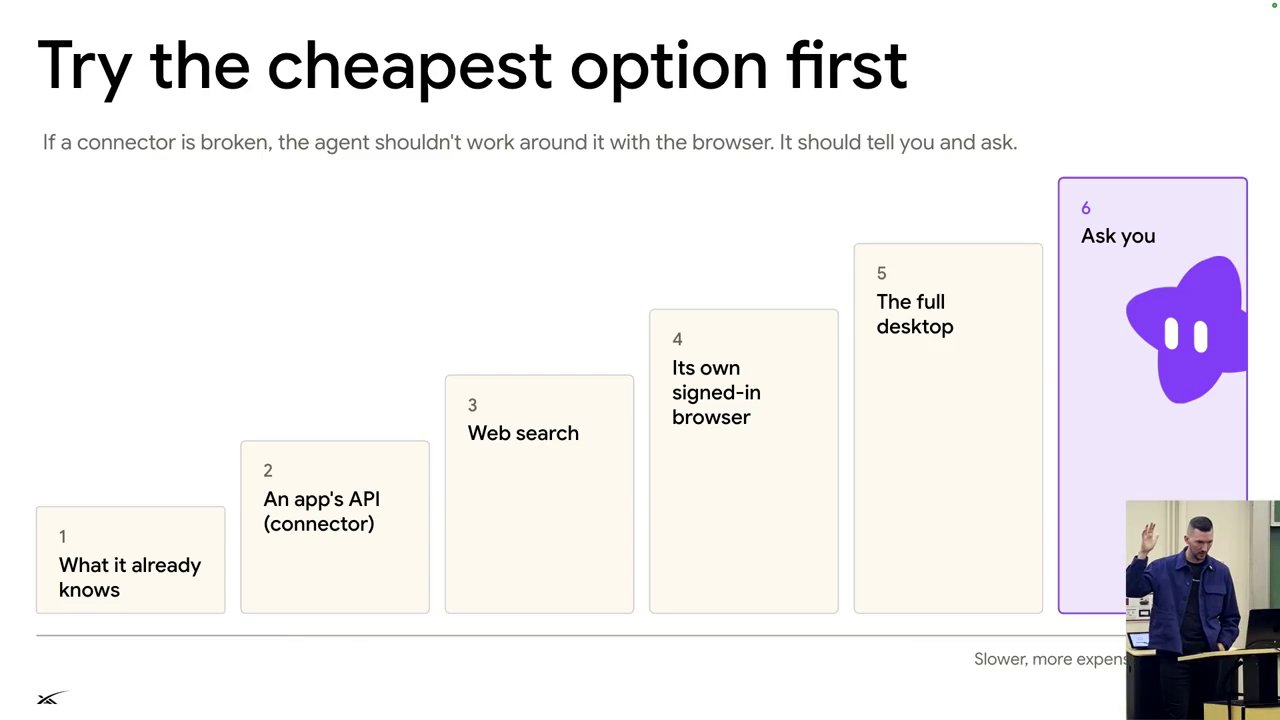
找資料也照成本排順序:先看對話裡已經知道的;不行就用 app 的 API 或 connector,例如從 Plaid 抓銀行資料;再來是網路搜尋;再來是用電腦上已登入的瀏覽器;再來是整台桌面跑腳本。全部都不行,才回頭問使用者,例如碰到兩步驟驗證碼或 CAPTCHA。
在瀏覽器裡看網頁也一樣,截圖最貴,讀 HTML 次之,讀 accessibility tree 最省 token,也最容易找到按鈕和連結。
六、主 agent 只負責講話,重活丟給 helper
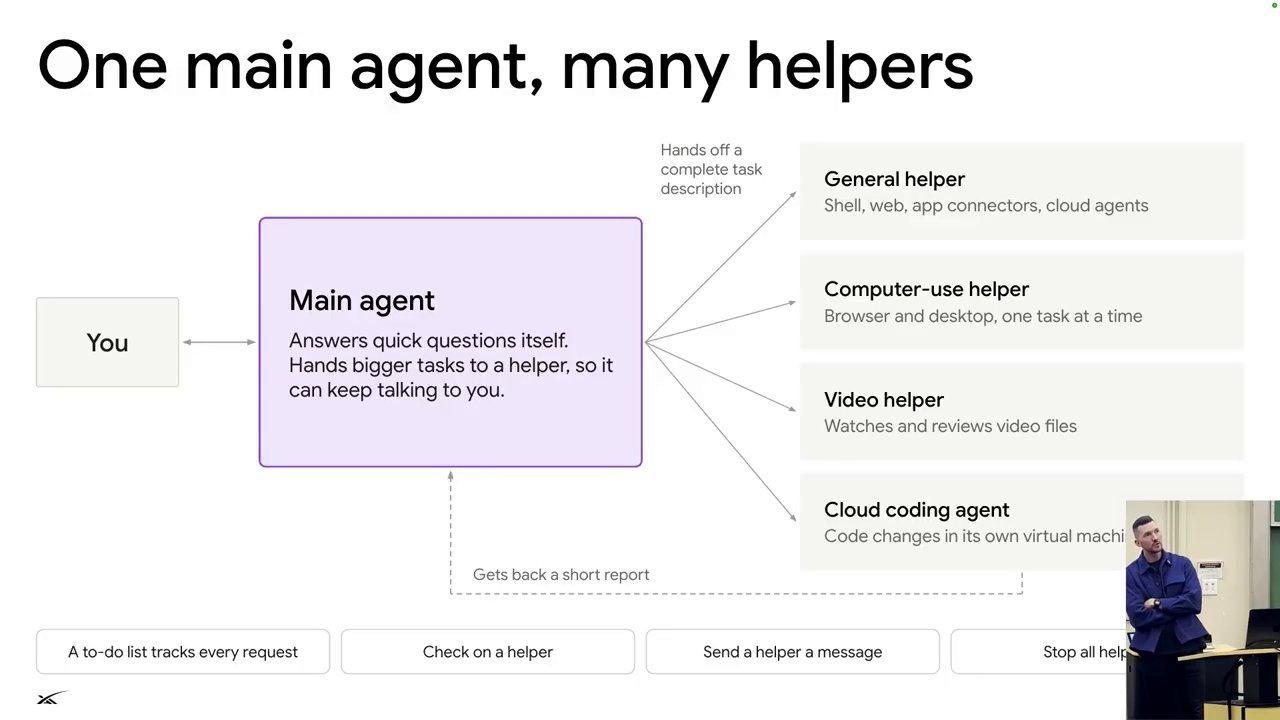
主 agent 像總管,對話要盡量保持精簡。跑一堆 shell 指令、耗很多 token 的工作交給 helper,也就是 subagent。過程不會塞進主 agent 的 context,只帶回結果,產品用起來才像有無限 context。
他們分成一般 helper、操作電腦的 helper、看影片的 helper、寫程式的 helper。每個 helper 都是獨立的 durable workflow,某個 helper 吃太多記憶體掛了,可以重啟接著做。主 agent 手上有待辦清單,可以去看 helper 的進度、傳訊息給它,或叫它停。
他也分享了幾個做 harness 的小心得:
- 一輪對話中間不要加減工具,工具說明和 schema 盡量精簡。
- 只給一個 shell 工具也能做很多事,但模型九成時間都在跑某種 shell 指令的話,做一個專用工具更有效率,也比較好看懂。
- 錯誤訊息要寫清楚下一步怎麼做,這對 agent 跟對人一樣有用。
七、cache miss 就是 bug
跟 agent 來回對話時,每次都是把整段對話重送,再加一則新訊息。模型供應商對已快取的 token 打很大的折扣,所以系統提示、工具定義這些開頭的部分要盡量固定,只有最新那段才付全價。
他提到今年 1 月 OpenClaw 爆紅,很多人拿它配訂閱方案在跑。那是供應商沒見過的用法,harness 也沒最佳化,cache miss 很多,後來修了很多地方才穩。
幾個實際做法:prompt 每一段可以算 hash、固定順序,做 A/B 測試加新段落也不會打亂別人的順序;使用者一打開聊天開始打字,伺服器就先把 prompt 準備好暖 cache,像網頁滑過連結就先預載。
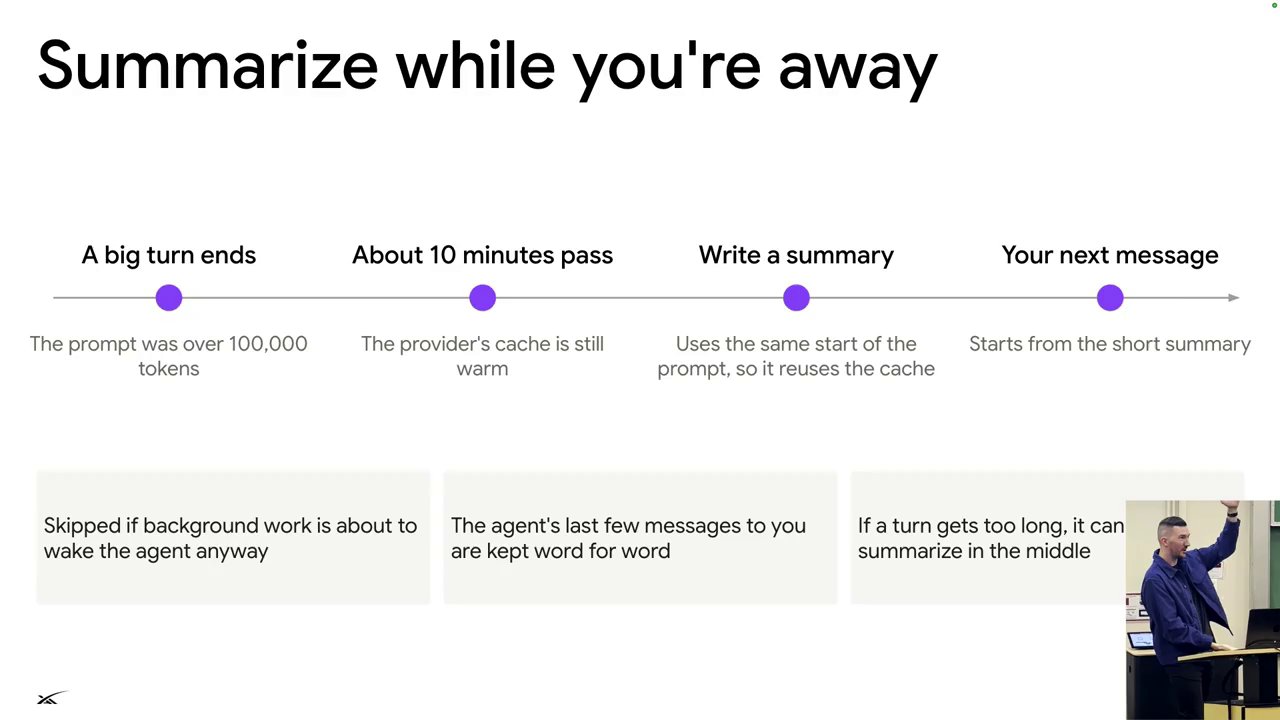
壓縮對話也搭著 cache 做。cache 熱著的時間大概 10 到 60 分鐘,對話已經超過十萬 token、你又去忙別的,就趁 cache 還熱先做 compaction,你回來時就從比較便宜的摘要接著聊。
cache miss 基本上就是系統裡的 bug。
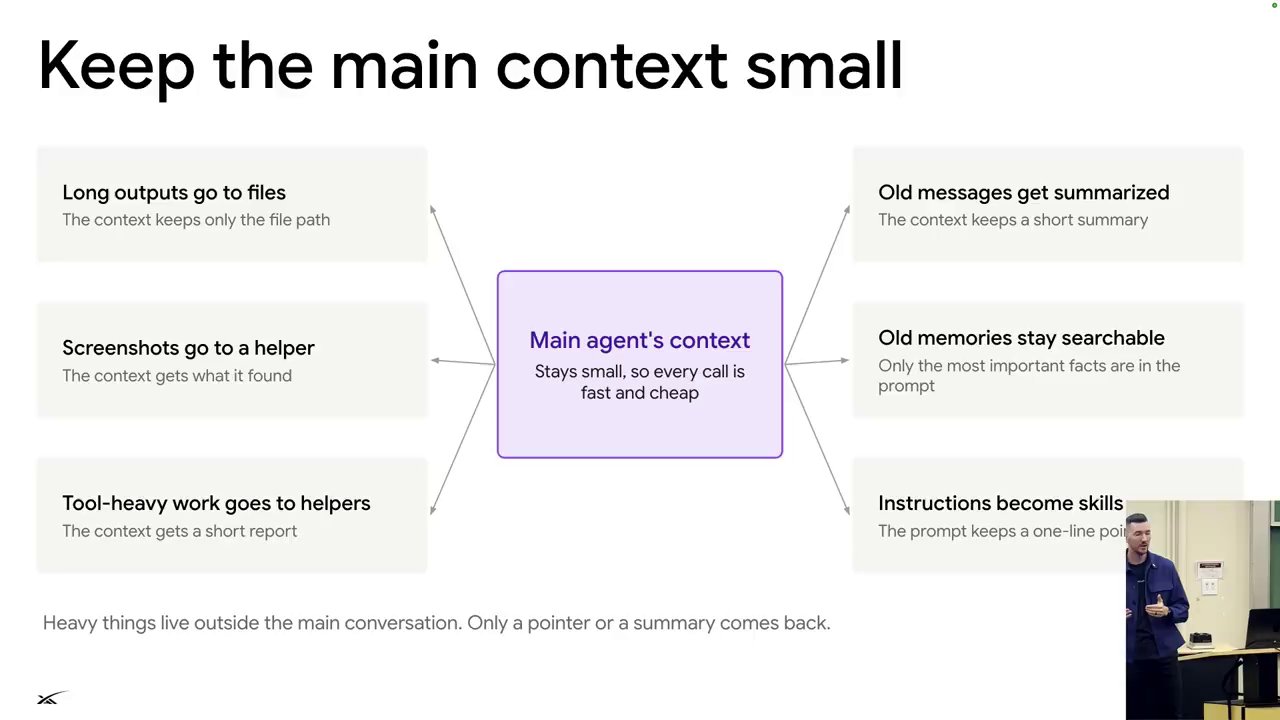
- 系統提示、工具定義放最前面並固定順序,一輪中間不要增減工具。
- 長輸出寫進檔案,截圖和重工具的工作交給 subagent。
- 使用者離開、cache 還熱時先做 compaction。
八、記憶分四層,其他的靠檔案找
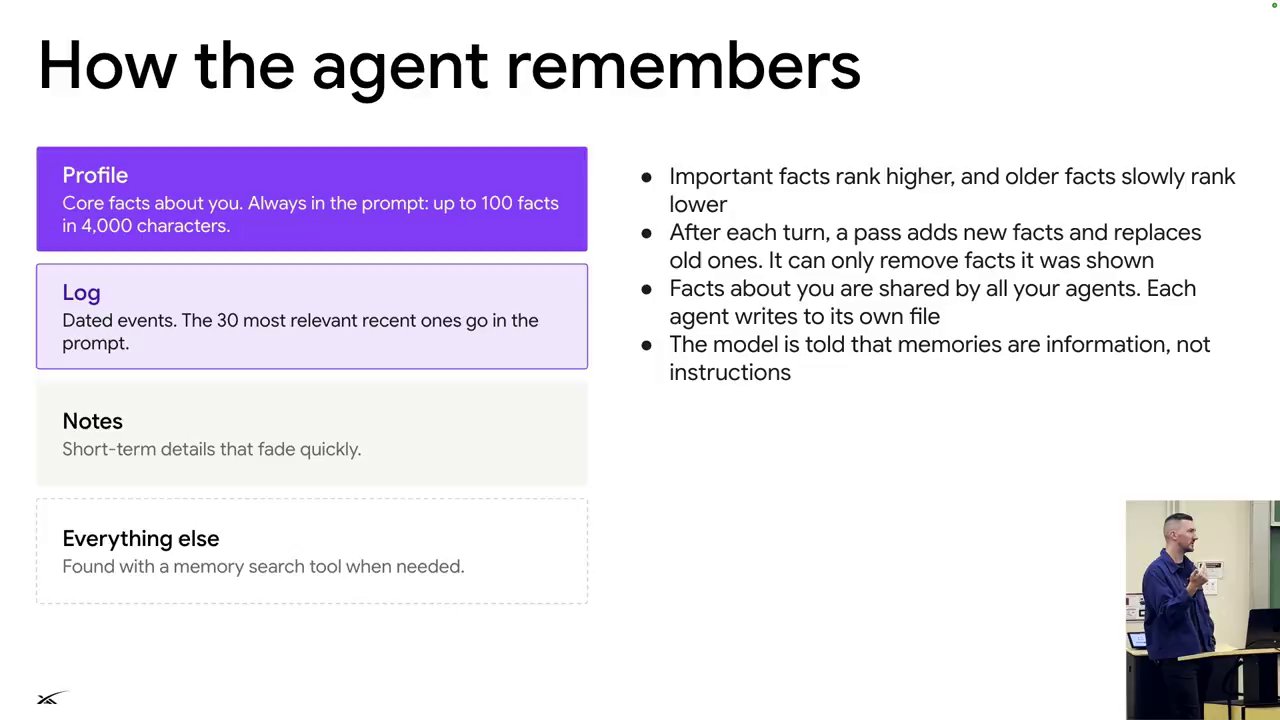
所有壓縮都會失真,要決定留什麼。他們把記憶分成四層:
| 層 | 放什麼 | 怎麼用 |
|---|---|---|
| Profile | 關於你的核心事實,例如你喜歡全小寫的訊息 | 每次都放進 prompt,最多 100 條、4,000 字元 |
| Log | 有日期的事件 | 挑最相關的 30 條近期紀錄放進 prompt |
| Notes | 短期細節 | 很快就淡掉,可能只在接下來半小時有用 |
| 其他 | 所有剩下的 | 需要時用記憶搜尋工具去找 |
投影片上還有幾條規則:重要的事實排前面,舊的慢慢往後;每輪結束跑一次整理,加新事實、換掉舊的,而且只能刪它看過的那些;所有 agent 共用關於你的事實,但各自寫自己的檔案;模型會被告知記憶是資訊,不是指令。
他說這有點像人腦:現在跟你有關的事留在腦中,其他先放一邊,需要時再想起來。模型很會下指令查檔案,所以剩下的都能靠檔案找回來。
九、模型會一直變強,要準備好砍掉產品重做
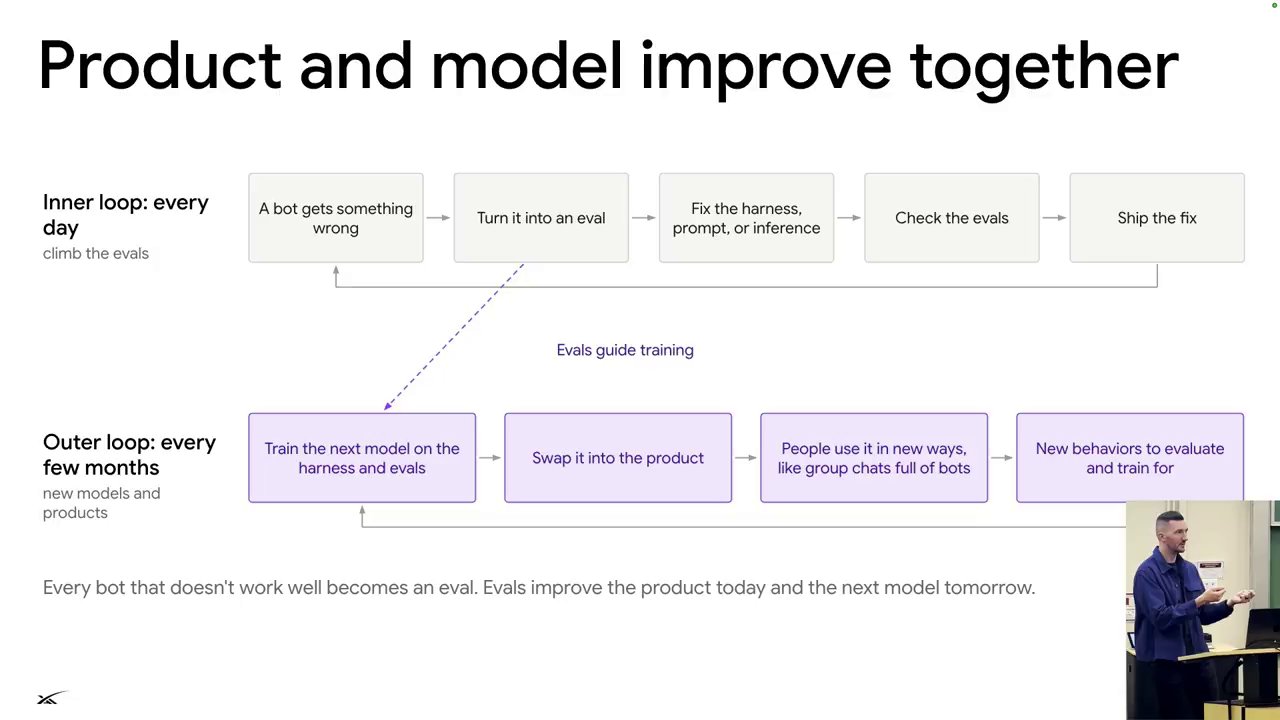
產品團隊每天跑內圈:agent 出錯,就變成一個 eval,修 harness、prompt 或推論,確認 eval 過了再上線。外圈是每隔幾個月訓練新模型,從這些錯誤學習,再換進產品裡。新模型帶來新能力,又會出現新的用法,例如多個 bot 在群組裡互相講話,這方面的訓練資料還很少。
他說 Cursor 和現在的 SpaceX 都有個原則叫「delete the product」:假設今天的模型是最爛的,半年後 UI 可能要整個重做。所以要替下一代模型做產品,能少做就少做。
接下來半年到一年,他認為 agent 會從跑幾小時變成跑幾週、幾個月,記憶會更好,介面會更簡單(例如直接用講的),模型更會在工作中學新技能,公司也會更懂得把流程寫下來讓 agent 看得懂。
他也丟了幾個還沒解的問題:agent 一跑就一個月、模型卻每個月更新,要怎麼評估?harness 和基礎設施怎麼防止被壞人接管?agent 什麼時候該安靜、什麼時候該主動提醒,他說還沒拿捏好。
明天就能做的事
- 把 agent 的長任務改成 durable workflow,失敗時從中斷那一步接著跑。
- 工具只先放名稱,細節等模型要用時再載入;一輪中間不要增減工具。
- 固定 prompt 開頭的順序,把 cache miss 當 bug 追。
- 長輸出寫進檔案,截圖和重工作交給 subagent。
- 錯誤訊息寫清楚下一步,讓 agent 也看得懂。
- 照課堂建議,自己動手做一個簡單版的常駐 agent,再多花點時間搞懂 LLM 怎麼訓練。
※ 來源:Lee Robinson(@leerob)在 X 的貼文與課程影片,Stanford CS146S,2026-10-08 授課。貼文附的章節:2:35 How we got here、6:13 What changed in the models、10:06 Inside an always-on agent、18:07 The harness、27:26 Context engineering、34:26 Where this is going。
※ 逐字稿以 Whisper(medium.en)轉寫 X 影片原音。X 沒有平台字幕,改對照投影片文字與貼文章節校正人名、數字和專有名詞。文中投影片截圖取自原影片。本文為非官方整理,以原影片為準。